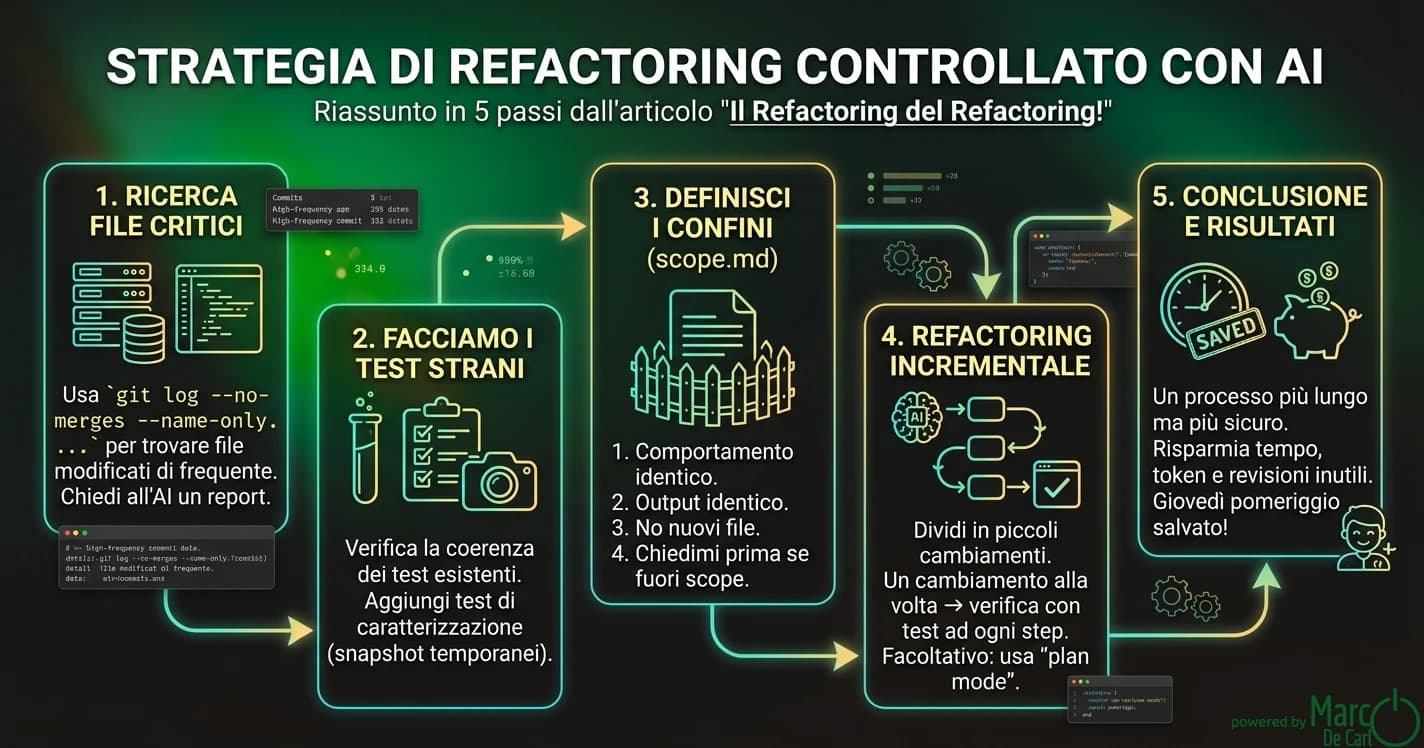
Nell’ultimo periodo ho provato varie tecniche e sperimentato nuovi metodi per trovare la giusta ricetta per effettuare un buon refactoring utilizzando l’AI.
Affidare l’intero processo di refactoring all’AI risultava molto complicato: spesso mi ritrovavo con moltissimi file modificati da revisionare e tutto questo richiedeva più tempo del previsto. In più comparivano file che non avevo richiesto di includere nel refactor.
L’AI, infatti, troverà sempre qualcos’altro da modificare, se nessuno la ferma, aumentando il rischio di introdurre nuovi bug senza accorgersene. Per lo sviluppo di una feature esiste un punto di arrivo; nel refactoring, invece, si potrebbe continuare all’infinito.
Alla fine mi sono ritrovato con 78 file da controllare e sicuramente non era quello che desideravo per il mio giovedì pomeriggio!
Per tutti questi motivi ho iniziato a sperimentare e adottare una strategia che rendesse effettivamente il lavoro più semplice e, soprattutto, più controllabile.
In questo “Appunto”, provo a raccontare gli step più significativi che utilizzo per arrivare a un buon risultato senza lasciarci le penne! Ovviamente questa strategia si adatta al progetto che seguo e non possiamo renderla assoluta, ma alcuni passaggi possono essere riciclati in diverse situazioni.
Per prima cosa individuo i file che vale davvero la pena prendere in considerazione per un refactoring. Non parto dai file che “sembrano brutti” con il codice disordinato, ma da quelli che vengono modificati più frequentemente.
Attraverso questo comando posso individuare i file modificati più frequentemente.
git log --no-merges --name-only --pretty=format: -- 'app/\*' | grep -v '^$' | sort | uniq -c | sort -rn | head -20
La lista che ricaviamo è un buon indicatore, ma non basta!
Adesso possiamo chiedere all’agente di analizzare questa lista e produrre un report spiegando quali file conviene rifattorizzare e perché.
Il risultato può essere salvato in un file oppure trasformato in una checklist, mantenendo così il contesto.
Il secondo passo è controllare che i test della sezione scelta siano completi e coerenti. In questo punto possiamo aggiungere i characterization test: test temporanei che fotografano il comportamento attuale dell’applicazione. Non devono necessariamente entrare nella suite ufficiale, ma mi permettono di verificare che il comportamento non cambi durante il refactor.
A questo punto creo anche un nuovo file chiamato scope.md, un piccolo contratto che definisce fin dove l’AI può spingersi. Ad esempio possiamo inserire:
Possiamo aggiungere altre istruzioni inerenti a quello che vogliamo ottenere, in sostanza, il file scope.md diventa un confine ben preciso che l’agente deve rispettare.
A questo punto arriva una delle parti che considero più importanti: evitare di chiedere all’AI di fare tutto insieme. Preferisco dividere il lavoro in piccoli cambiamenti.
Una modifica → verifica → modifica successiva → verifica
Dopo ogni cambiamento voglio poter eseguire i test, l’analisi e il linting. In questo modo, se qualcosa si rompe, è molto più semplice capire quale modifica ha causato il problema perché non avremo 78 file da revisionare!
In alcuni casi, utilizzo anche la plan mode, facendo analizzare il contesto all’agente e producendo un piano di lavoro. In questo modo posso verificare in anticipo:
Solo dopo aver revisionato il piano gli permetto di modificare il codice. Così facendo posso correggere la direzione, aggiungere vincoli o modificarne il contesto prima che vengano effettuate modifiche reali.
A prima vista questo processo può sembrare più lungo e costoso, ma in realtà mi ha fatto risparmiare tempo, token e revisioni inutili!
Dare meno libertà all’AI, aggiungere del contesto di qualità e fare verifiche più frequenti hanno migliorato il mio modo di fare refactoring e salvato i miei giovedì pomeriggio!